
ハカセ アイ(Ai-Hakase)🐾生成AI・ComfyUI
@ai_hakase_
🎬【AI動画の革命】顔が変わる悩み、もう卒業しませんか? 「Wan 2.2」と「LTX 2.3」を組み合わせた、究極のハイブリッド・ワークフローがついに登場しました!✨ キャラクターの顔をしっかり維持しながら、音付きの長尺動画が思い通りに作れるんです!🚀 👇️ このスレッドで解説していきます!

由 Lightricks 打造的 LTX 系列支持实时视频生成,物理运动表现自然,帧与帧之间动作稳定。输入文字提示词或参考图,即可生成干净、可直接进入后期的视频片段,并体验 LTX 各大模型。
生成器工作区
AI 图片生成器
输入提示词开始生成视频。每次任务独立维护自己的输入和参数。
AI 视频生成器
输入提示词开始生成视频

Lightricks · LTX series
LTX AI 是从 Lightricks 分出的 AI 视频与世界模型业务。Lightricks 是创立于 2013 年的以色列创意技术公司,2024 年 2 月发布 LTX Studio 后,于 2026 年拆分为两部分:主攻开放视频模型与基础设施的 LTX,以及消费应用业务。LTX 自称“开放世界模型公司”,构建能理解世界外观与运动方式的基础模型,服务于影视、机器人与工业仿真。
LTX 将其核心视频模型以开放权重形式发布。LTX-2 于 2025 年 10 月发布、2026 年 1 月开源,随之提供模型权重、代码与工具链,机构可在自有硬件上运行、微调与扩展。年度经常性收入低于 1000 万美元的机构可免费使用,规模更大的企业需协商授权。自 LTX-2 发布以来,LTX 系列在 Hugging Face 的下载量已突破 3300 万次,是市场上使用量最大的开放“世界模型”系列。
与“先生成无声视频、事后再加音频”的流水线不同,LTX-2 是一个非对称双流 Transformer,在单次统一计算中同时生成视频与同步音频。参数量为 140 亿的视频流与 50 亿的音频流通过双向交叉注意力耦合,对白、口型、环境声与拟音效一次生成,而不是在后期拼接。LTX-2 可输出最长 20 秒、原生 4K、最高 50fps 的视频片段,在 NVFP8 量化下仅需 16GB 显存的消费级 GPU 即可运行。
时间一致性——让物体、质感、人脸与运动在每一帧上都保持稳定——被普遍视为 AI 视频生成中最难的问题。LTX-2.5 从结构上解决它:时空 Transformer 将各帧联合推理而非独立推理;扩散视频解码器在快速运动中仍能保持细节稳定;原生多镜头生成将整段序列作为单一输出渲染,跨切点保持角色、场景与声音一致,而不是把分别生成的镜头拼接起来。
LTX 将其模型定位为可直接投入生产,而非演示级产品。LTX-2.5 在 Fast 档位下以每秒 0.09 美元的价格生成带音频的 720p 视频——约为同类 Veo 3.1 输出成本的四分之一——并称在优化硬件上,成本可降至同类模型的八分之一、渲染时间可降至七分之一。LTX Studio 在这些模型之上提供原生 4K 竖屏视频、面向图生视频工作流的关键帧控制以及重构的音频流水线,让生成从“凭提示词碰运气”变为可导演的运动。
关注 LTX 官方 X 账号、Hugging Face、GitHub、Discord 与文档站等渠道,第一时间订阅模型发布、技术报告与平台更新。
@ltx_io
官方 LTX 账号 · 2024 年 2 月加入LTX(由 Lightricks 打造)的官方 X 账号,发布模型版本、能力演示、研究记录与平台动态。
第一代 · 13B 参数
选它,如果你:不需要音频,并且想用最丰富的 LoRA 资源。
精修一代
选它,如果你:素材从一张静帧出发,并且是单镜头。
多镜头生成 · 22B 级别
选它,如果你:一段成片要包含多个镜头且维持同一角色。
探索 LTX 模型的多模态特性 - 通过提示词让 LTX 生成高质量视频来完成电影级视频的制作。图片秒变真实视频,LTX 可将真实的记忆制作为大师级纪录片。更强大的是,LTX 能够出色的完成视频画面修改,无需专业技能即可重新制作视频片段,完成内容重构。这款先进的 AI 可在各种创意项目中提供专业品质的视频生成效果,保持复杂人物形象一致性,帮助您完美实现所有的想法。
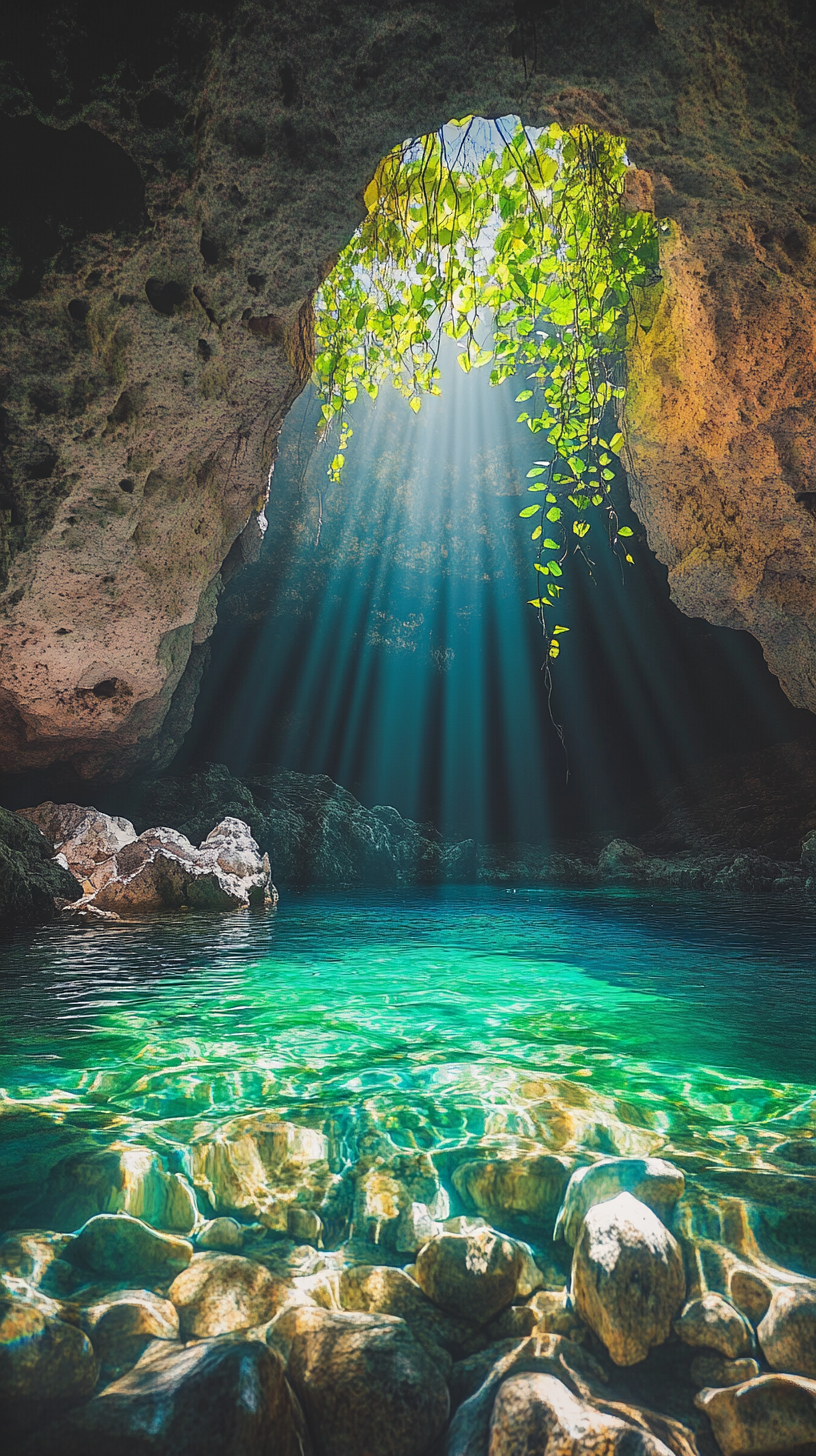
A serene, hidden cave pool with crystal-clear turquoise water and smooth stones beneath the surface, illuminated by dramatic beams of sunlight pouring through an opening above. Sunlight filters down in shifting rays as leaves dangle gently overhead. The water glistens and ripples softly, creating a mesmerizing dance of light across the cave walls and stone floor. The cave's textured rock walls are dappled with light and shadow, with hanging vines and greenery trailing through the skylight. Beyond the lit area, the cavern fades into cool, mysterious shadows. The vine leaves sway gently in the breeze, and soft currents in the pool create shimmering refractions on the rocky ceiling and walls. Occasional droplets of water fall from the cave roof into the lagoon. A slow dolly-in across the water's surface, gliding just above the glowing stones. The camera then tilts upward toward the cascading sunlight and hanging greenery, revealing the full height and intimacy of the cavern.
浏览器、API 调用或自有显卡——三种方式用的是同一套模型。
在线
打开浏览器里的在线 Playground,用文字提示词或参考图即可开始。无需安装、无需显卡、无需自建账号体系,即可获得积分额度、预设模板库和原生 4K 导出。
前往在线体验
API 调用
用 HTTP 提交文生视频、图生视频任务,一次请求即可拿到带音画的成片。模型 ID、时长、分辨率、关键帧与音频选项都是请求参数,可以把 LTX 直接接入你自己的产品。
查看 API 文档
私有化部署
从 Hugging Face 下载开放权重,用 Diffusers 或 ComfyUI 工作流运行,并基于 LoRA 微调出自己的风格。素材与数据始终留在你自己的基础设施内。
获取开放权重
获取方式确定之后,每一次生成都走同样五个阶段,下面说明每一步究竟在控制什么。
从想法出发选文生视频,手上已有首帧、角色设定图或产品图则选图生视频。再选版本:追求最新画质用 LTX-2.5,兼顾成本用 LTX-2,需要 LoRA 做风格实验用 LTXV。
按「主体 → 动作 → 镜头运动 → 光线 → 风格」的顺序描述。保持画面中只有一个明确的主体在运动,写明景别(特写、推镜头、手持),并交代哪些元素必须保持一致:角色外貌、服装、色调。
按投放渠道选择画幅与分辨率,把时长控制在模型支持范围内,并决定是否在同一次生成中产出音频。原生同步音频与口型对齐的效果远好于后期配音。
提交任务——在线版大多数 LTX 生成几秒内即可完成。重点检查闪烁、肢体变形和背景漂移,发现问题就把它写进提示词里,而不是反复重抽。
用多镜头生成或关键帧把满意的镜头接长,再放大到 4K,最后导出文件,并把提示词与随机种子一起保存,方便日后复现同一个镜头。
小技巧:结果不理想时,一次只改一个变量——提示词措辞、种子或模型版本。这样才能真正知道是哪一处改变了输出。
走进 LTX 视频生成的世界,看看如何使用 LTX 在充满灵感的空间中将创意变为现实
来自社区的真实帖子——从 LTX-2.3 的图生视频实测,到带同步音频的多镜头序列。点击任意卡片可查看 X 上的原帖。
ハカセ アイ(Ai-Hakase)🐾生成AI・ComfyUI
@ai_hakase_
🎬【AI動画の革命】顔が変わる悩み、もう卒業しませんか? 「Wan 2.2」と「LTX 2.3」を組み合わせた、究極のハイブリッド・ワークフローがついに登場しました!✨ キャラクターの顔をしっかり維持しながら、音付きの長尺動画が思い通りに作れるんです!🚀 👇️ このスレッドで解説していきます!

Spectro
@Spectromachina
Same prompt, same starting image, one is google omni, one is LTX 2.3 I generated for free with my GPU. You be the judge. Omni is great for editing, not so great for creating videos. @LTXStudio @GoogleDeepMind


R@aiaicreate
@aiaicreate
LTX 2.3の動画生成において、既存の有名楽曲に酷似した音声が生成されたとの報告。 学習データに含まれる著作物の出力の可能性を示唆する声。 #LTX #動画生成AI URLはリプ⬇️

Wildminder
@wildmindai
LTX is cooking hard. Just-Dub-It IC LoRA, and you can dub anything. - Instead of separate steps for voice and lips, it generates them simultaneously - handles occlusions and profile views - beats HeyGen/MuseTalk - maintains bg noise and speaker identity also it stretches the video and audio together so the pacing matches the new language perfectly. Just awesome! https://justdubit.github.io/

Wildminder
@wildmindai
LTX2.3 OmniNFT RL-LoRA generates high-quality video/audio + visuals and sound are perfectly synchronized, no laggy or mismatched audio - realistic Lip-Sync - action-matched sound - reduces synchronization errors by 52% really nice output https://zghhui.github.io/OmniNFT/


Hirokazu Yokohara
@Yokohara_h
生成した動画をHDR化するLTX-2.3のHDR LoRAのテスト EXRで書き出せるから撮影素材やCGと馴染ませたりグレーディングが可能になるやつ ローカルでも動くし白飛びも復元されてて品質悪くないのでこれは常用

创作者、开发者和团队谈 LTX 本身最能打的地方——生成速度、音画同步、时间一致性,以及开放权重。
“LTX 2.5 几秒钟就能出一条可用的 720p 镜头。以前要等一杯咖啡的时间,现在按一下就出来,我直接在这个生成器里分镜。”
陈晓明
LTX 2.5 用户 · 短视频制作人
“双流架构才是关键。LTX 一次生成对白和口型,我再也不用逐句修十几帧嘴型来补配音。”
林思涵
LTX-2 用户 · 广告创意总监
“我们把 LTX 开放权重跑在自己的集群上,还微调了公司风格的 LoRA。素材不出楼,授权条款也确实允许这么做。”
张伟
私有化部署 LTX-2 · 影视技术总监
“时间一致性是 LTX 胜过我们测过的所有模型的地方。角色在镜头切换中容貌和服装都能保持,这种速度下我从没见过。”
田中优树
LTX 2.5 用户 · 独立电影导演
“多镜头生成改变了我们的广告流程。一条提示词就能产出跨镜头保持一致的序列,剪辑里不用再拼接零散片段。”
王丽
LTX-2 用户 · 效果营销负责人
“原生 4K 竖屏输出加上 API,客户改需求只是改一个参数,而不是重拍。LTX 是我们客户会直接点名要的模型。”
白大伟
LTX API 用户 · 自由后期制作师
关于 LTX 的使用、部署与提示词优化,以及可控参数、适用场景、授权方式和社区入口。
有两点。一是 LTX 把画面和同步音频放在一次统一生成中完成——对白、口型和环境声一起产出,而不是事后配音;二是核心模型以开放权重发布,可以自行微调和部署。质量上,它把时间一致性当作核心问题而非后处理步骤,因此角色、服装和场景在镜头切换之间都能保持稳定。
在托管服务上,大多数 LTX 生成以秒计而非以分钟计,这正是提示词能快速迭代的原因——慢模型出一次片的时间,足够你重抽好几版。本地生成速度取决于硬件、模型版本、分辨率、片长以及是否启用音频。
模式:文生视频、图生视频、关键帧与多镜头。模型版本:LTXV、LTX-2、LTX-2.3、LTX-2.5。输出:分辨率与画幅(含原生 4K 与竖屏)、片长最长 20 秒、帧率最高 50fps、音频开关,以及用于复现的随机种子和支持风格与镜头控制的 LoRA。图生视频时,LTX 可读取 JPG、PNG、WEBP 的关键帧。
开放权重对年经常性收入低于 1000 万美元的组织免费,更大的公司需与 Lightricks 协商授权。在托管服务上按生成量计费——例如 LTX-2.5 Fast 档 720p 带音频约每秒 0.09 美元。在本站使用按次数消耗积分,限制来自你的余额,而不是模型本身的配额。
可以。开放模型权重可用于商业用途:年经常性收入低于 1000 万美元的组织免费使用,超过该门槛需协商授权;托管服务产出的内容则遵循对应服务商的条款。具体请以你所部署版本的 Hugging Face Model Card 为准。
取决于你的使用方式。通过托管服务使用时,提示词与产出的保留规则由该服务商决定;私有化部署时,LTX-2 完全跑在你自己硬件上,素材和提示词都不会离开你的基础设施——这也是对素材敏感的团队选择开放权重的主要原因。
三种方式通向同一套模型:在浏览器里用在线 Playground;从自己的产品调用 API;或从 Hugging Face 下载开放权重,用 Diffusers 或 ComfyUI 本地运行。你选的是交付方式,而不是另一个模型。
按这个顺序描述:主体 → 动作 → 镜头运动 → 光线 → 风格。保持画面中只有一个明确的主体在运动,写明景别(特写、推镜头、手持),并交代必须保持一致的元素——面部、服装、色调。结果不理想时一次只改一个变量(措辞、种子或模型版本),这样才能知道是什么改变了输出。
可以。LTX-2 提供开放权重、代码和工具链,可用于本地部署。采用 NVFP8 量化后,消费级 16GB 显存的显卡即可运行;更大的集群则按分辨率、片长和批量扩展。
LTX 擅长快速迭代、跨镜头保持角色一致、对白与口型同步,以及主体明确的商品与广告镜头。如果是有大量不同角色的长叙事,或要求单张静帧就能把背景每个细节做到像素级一致的素材,它并不是最优选择。
关注 X 上的 @ltx_io 获取发布与演示,加入官方 Discord 咨询使用问题、查看社区工作流;版本发布、LoRA 与文档则以 Lightricks 的 GitHub 和 Hugging Face 页面为准。
加入数千名用 LTX 生成视频的创作者。免费 30 积分开始,无需信用卡,文本、图像与音频工作流一站完成。